第2章:「よかった」が「よがんた」になる

「よかった」と打ったつもりが、画面には「よがんた」という文字列が出ることがありました。 ローマ字入力ではなく、親指キーとの同時打鍵で仮名を決めるNICOLA方式ならではの化け方です。 入力を受け取る側のコードに誤りがあったわけではありません。二つのキーがほぼ同時に押された とき、その「ほぼ同時」をどちらの文字に結びつけるべきかという判定そのものが、際どい場合には 決めようがなかったのです。
第1章では、キーを受け取り、NICOLAの規則で判定し、仮名を出力するまでの経路を 組み立てました。この章で扱うのは、その経路の中でもとりわけ小さな、しかし避けようのない 曖昧さです。二つのキーがほぼ同時に届いたとき、どちらを先とみなすべきか。時間だけでは 決め切れないこの問いに、awaseは意外な道具で答えることになります。
三つのキーが並んだとき、親指はどちらと組むか
NICOLA方式の親指シフトでは、文字キーと親指キーをほぼ同時に押すことで一つの仮名を確定 させます。ここで厄介なのは、char1→thumb→char2という順で三つのキーが短時間に並んだ 場合です。親指キーは、直前の文字キー(char1)と組むべきか、直後の文字キー(char2)と 組むべきか。両者は排他的な二つの仮名を生み出すため、どちらか一方に決めなければなりません。
src/engine/timing.rsには、この判定を「3キー仲裁」と呼ぶコメントが残っています。
/// 3キー仲裁: char1→thumb→char2 の並びで、thumb をどちらとペアリングするか。
最初の判定方法は単純でした。char1とthumbの間隔(d1)と、thumbとchar2の間隔(d2)を比べ、 d1のほうが短ければchar1と組む、というものです。人間の指がキーを押す物理的な間隔を、 そのまま判定材料にする発想であり、これ自体は自然な出発点でした。
タイミングだけでは、決まらない場合がある
ところがこの単純な比較には、見過ごされていた偏りがありました。自然な打鍵では、直前の キーとの間隔(d1)のほうが、直後のキーとの間隔(d2)より短くなりやすいのです。指の運動として 「押してすぐ次を押す」ほうが「押してからやや間を置いて次を押す」より起こりやすいという、 人間の側の癖でした。
この癖のせいで、「か」に続けて右親指(濁点相当のシフト)を押し、その後「ん」を打つと、 d1が短くなりがちなために「か+右親指=が」が選ばれ、続けて「ん」「た」と打った結果が 「がんた」になってしまいます。「よ」「か」「thumb」「っ」「た」という五打鍵のうち、 中央の三打鍵の親指帰属だけが逆に判定され、「よかった」ではなく「よがんた」という、 意味の異なる文字列が出力されていました。
打鍵のたびに毎回起こるわけではありません。d1とd2の差が十分に大きければ、タイミングの 比較だけで問題なく判定できます。問題が起きるのは、二つの間隔が拮抗し、どちらとも言い切れない ときだけでした。この「際どいときにだけ間違える」という性質が、原因の特定を難しくして いました。
統計的な文脈を、判定材料に加える
タイミングが拮抗しているなら、タイミング以外の材料で決めるしかありません。ここでawaseが 持ち込んだのが、直前までに確定した文字列という文脈でした。「よ」の後には「かった」が続き やすく、「よ」の後に「がんた」が続く頻度は低い。この日本語としての自然さを、確率として 持っておけば、タイミングが決め切れない場合の判定材料になります。
src/ngram.rsには、この考え方を実装したNgramModelが定義されています。持っている
データは二つの頻度表(直前1文字から見た二文字の連なりの確率をbigram、直前2文字から
見た三文字の連なりの確率をtrigramと呼びます)と、そこから導いた閾値を何マイクロ秒まで
動かしてよいかという上下限だけです。文字の並びを丸ごと覚えるのではなく、「この二文字
(三文字)がどれだけ自然に連続するか」という一点だけを、あらかじめ数値にしておく設計
でした。
このモデルを最初に実装したコミット6990a7dは、2026年3月28日21時17分のものでした。
awaseの開発が始まったまさにその日、プロトタイプが動いた同じ日のうちに、この統計モデルの
土台はすでに置かれていたことになります。
three_key_pairingの判定フローは、次の三段階でした(timing.rsのコメントより)。
判定フロー:
1. n-gram なし → タイミング比較(d1 < d2 なら char1)
2. タイミング差が大きい(30%マージン超)→ タイミング優先
3. タイミングが接近 → n-gram スコアで判定
図にすると、タイミングの差が大きい間はn-gramへ迂回しないことがはっきりします。
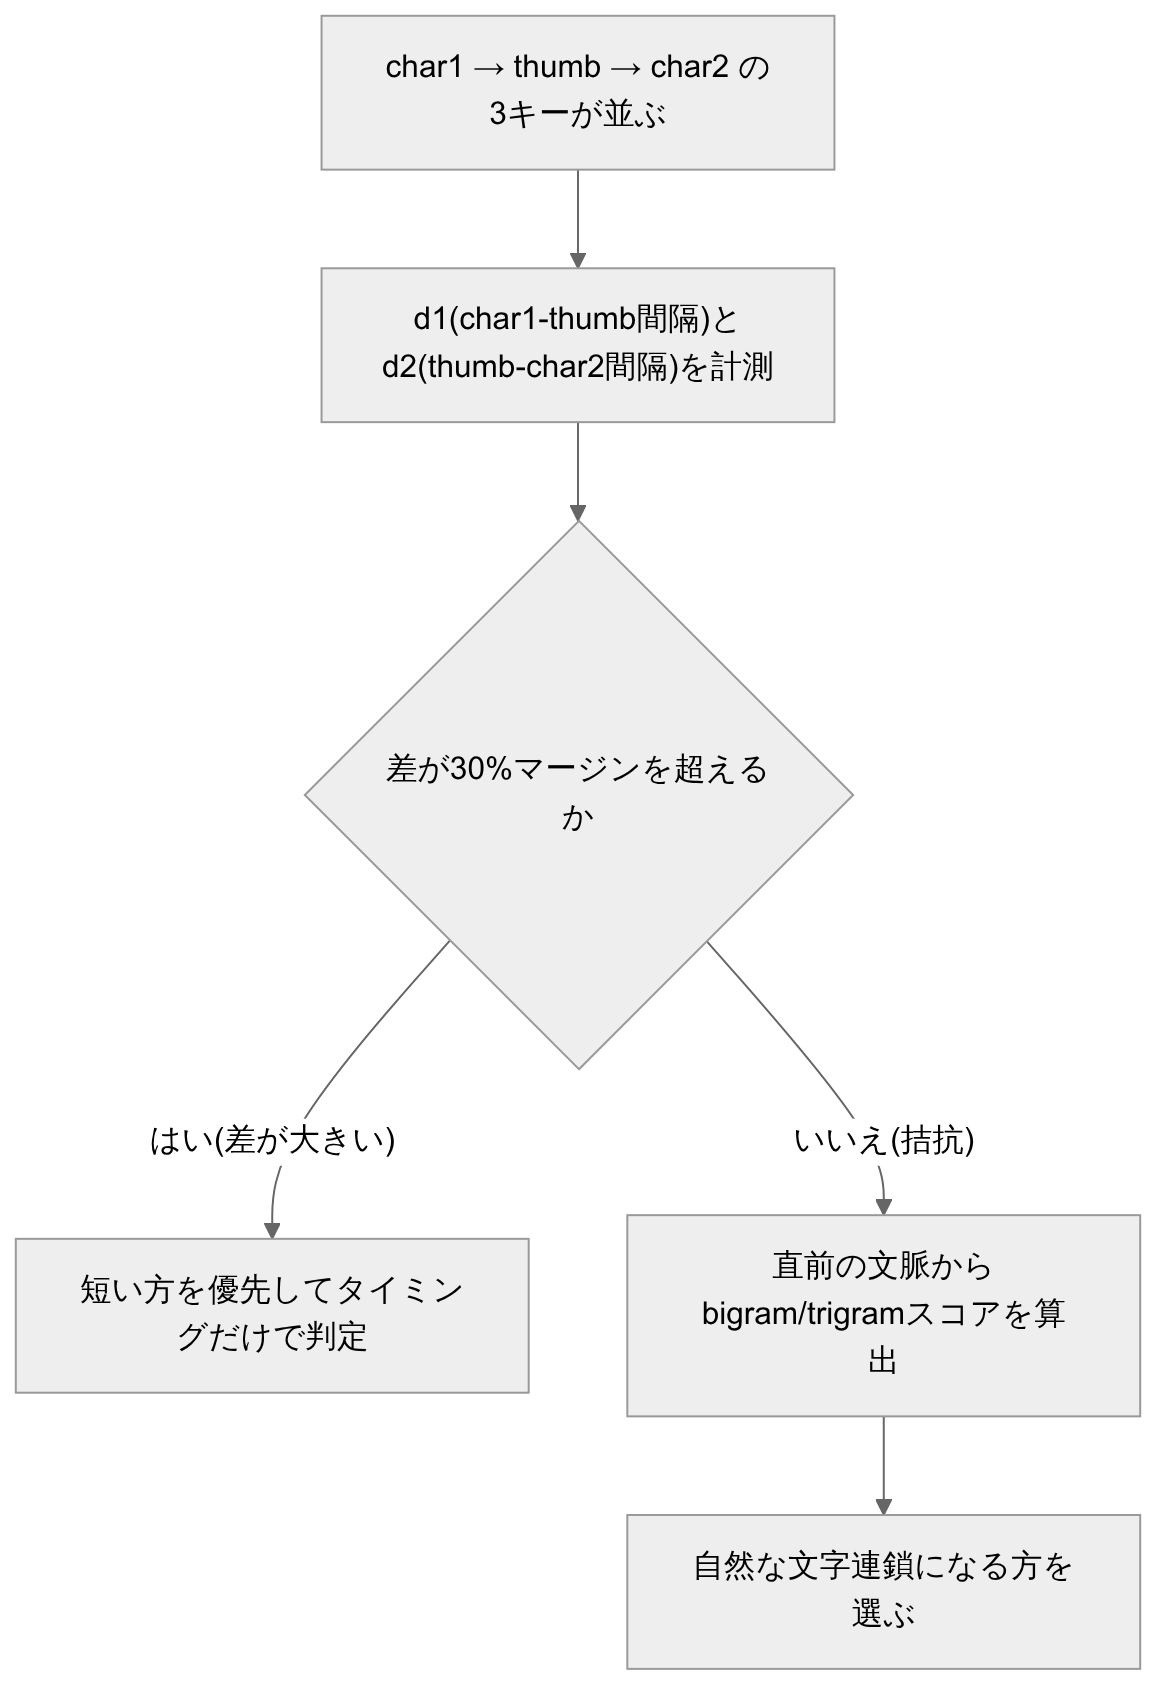
n-gramスコアは、タイミングに取って代わるものではありません。呼び出されるのは、 タイミングが際どく単独では決め切れない場合だけでした。
Wikipediaをひらがなにして、頻度表を作る
このbigram/trigramの頻度データは、どこから来たのでしょうか。data/ngram_hiragana.csv.gzの
ヘッダーには、出所が明記されています。
# Auto-generated hiragana n-gram frequency table
# Source: Japanese Wikipedia (CirrusSearch dump)
# Analyzer: Sudachi.rs (UniDic) + ambiguous reading correction
ARCHITECTURE.mdにも、同じ手順がやや詳しく記されています。
日本語の百科事典の本文まるごとを、意味のある単語としてではなく、ひらがなの連鎖という 音の並びとして数え直す。もとは知識を記述するための文章が、ここでは「どの仮名の後に どの仮名が続きやすいか」という、タイミング判定のための統計値に姿を変えています。
生成過程を実行した具体的なツールも、探してみると見つかりました。build-ngramという、
awase本体とは別の小さなRustプロジェクトです。Wikipediaのダンプから短すぎる文を除いて
取り出し、Sudachi.rsで形態素解析してからbigram・trigramの出現頻度を数え上げます。
この過程では「今日」は次に「は」が続けば「コンニチ」(こんにちは)、それ以外は「キョウ」と
読むというように、同じ表記でも前後の文脈で読みが変わる語(多読字)をルールベースの表で
補正しています。
このツール自体のファイルが最後に書き換えられた時刻を見ると、awase本体にNgramModelが 組み込まれたコミット(21時17分)より何時間も前、同じ3月28日の早朝から午後にかけて、 Wikipediaを処理するための専用ツールが先に作られていたことが分かります。プロトタイプが 動いた同じ一日のうちに、コーパスを作る側の作業まで進んでいたのです。
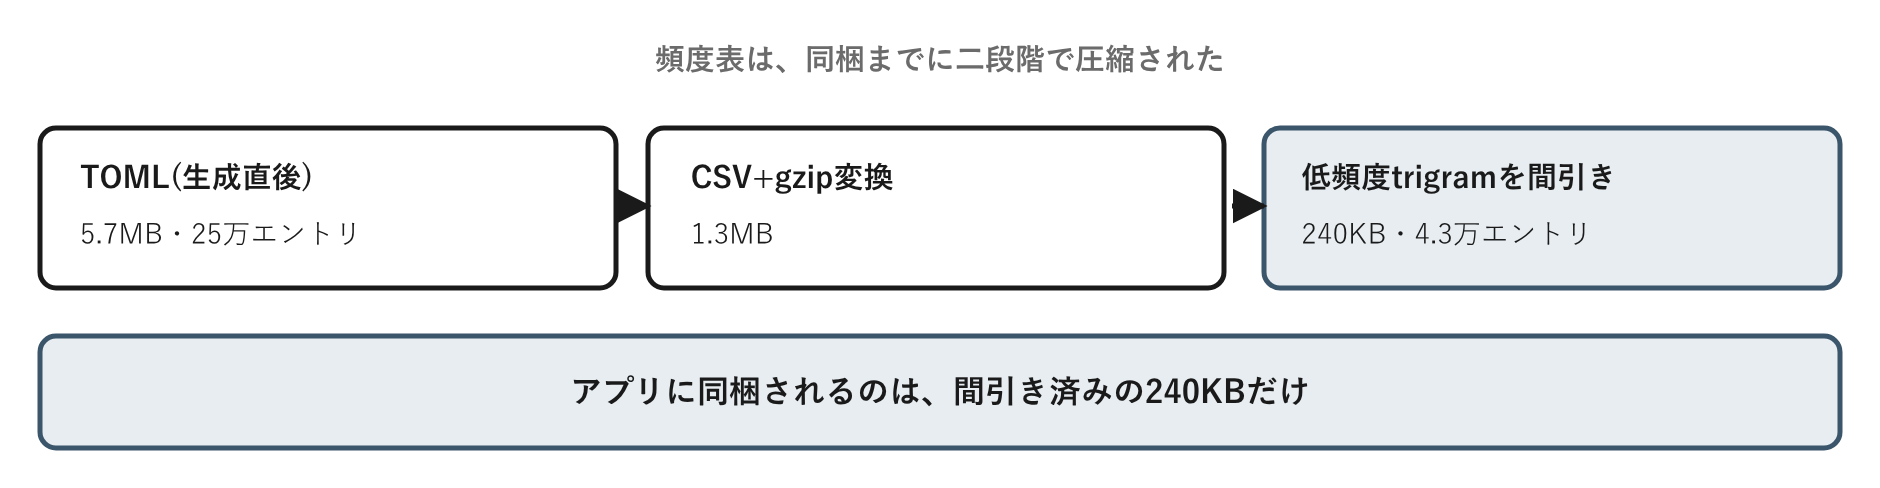
生成されたデータは、決して小さくありませんでした。TOML形式で5.7MB、25万エントリ。 これをアプリに同梱するには重すぎます。3月30日、CSV+gzip形式への変換で1.3MB(23時41分の コミット)まで圧縮し、さらに8分後、スコアが一定より低い低頻度のtrigramを間引くことで 240KBまで削りました。25万エントリのうち、実際に残されたのは4万3千エントリほどです。 どちらの段階でどれだけ小さくなったかをまとめると、次のようになります。
際どさの外側では、統計は口を出さない
n-gramスコアの使われ方をもう一度確認します。frequency_score()はまずtrigramを参照し、
無ければbigramにフォールバックし、それでも無ければ0.0という中立値を返します。このスコアを
tanhで-1から1の範囲に正規化し、既定では前後20ミリ秒の調整幅に掛けて、30ミリ秒から
120ミリ秒という範囲に収まるよう閾値を動かします。
大事なのは、この仕組みが「かな漢字変換の候補を選ぶ」ためのものではないという点です。 awase自身は、かな漢字変換を行いません。それはOS側のIMEの役目です。awaseが決めているのは、 あくまで「どの一文字の仮名を確定させるか」という、もっと手前の一点だけでした。
2026年5月8日、1f93e7dというコミットで、このn-gramモデルを設定ファイル上で明示的に
有効化する変更が入りました。コミットメッセージには、この章の冒頭で挙げた「よかった」が
「よがんた」になる現象が、3キー仲裁でn-gramモデルが効いていないことに起因すると
記録されています。
この3キー仲裁を呼び出す側のNicolaFsm自体にも、見過ごされていた問題がありました。
初期の実装は、再帰呼び出しによるresolve・handle_idle・combine_prev_and_newという
形で書かれていました。動いてはいましたが、読みやすいとは言えないコードでした。3月30日の
ADR-015は、この実装が抱える問題を次の三点に絞って言語化しています。
update_history()がfinalize_plan()の外でも呼ばれる(履歴更新の経路が分散)combine_prev_and_new()で2つの Response を手動マージ(脆い)self.physの暗黙依存(再帰の奥で何を参照しているか不明)
ADR-015が採った解決は、起こりうる遷移のパターンをあらかじめParseActionという列挙型に
書き出すことでした。実装を担ったClaude Opus 4.6が積んだ同日中の二つのコミット
(0edf8e8・526f898)で、手動マージだったcombine_prev_and_newは削除され、分散していた
update_historyの呼び出しもループ内の一箇所に集約されています。「何が問題か」を先に
三点へ絞って言語化してから実装を任せる進め方は、この章のn-gramモデルと同じく、際どい
判定を確実に処理へ落とし込むための工夫の一つでした。
他分野への転用
際どい判定にだけ、独立した手がかりを足す
一つの観測だけでは判定が際どくなる場面は、日本語入力に限りません。予測変換やオート コンプリートも、直前の入力だけでは次の候補を絞り切れないとき、単語の出現頻度という 統計的な文脈を判定材料に加えます。センサーフュージョンの分野でも、単一のセンサー値が 拮抗して読み取れないとき、過去の動きのパターンや周囲の情報といった、観測そのものとは 別の手がかりを組み合わせる設計が広く使われています。awaseがタイミングにn-gramを足した 構図は、この一般的なパターンの一例にすぎません。
ただし、この組み合わせは万能ではありません。観測同士の差が十分大きいときには、単一の 観測をそのまま信じるほうが速く、かつ正確です。統計的な補正は、観測同士が拮抗している、 まさにその瞬間にだけ呼び出されるべきものであり、常時介入させると、かえって本来明確 だったはずの判断を曖昧にしてしまいます。
タイミングが意味を持つ入力は、層に分けにくい
NICOLA方式のように、キーを押す間隔そのものが確定する文字を左右する入力方式は、この本が 初めて出会った設計ではありません。身近な例で言えば、スマートフォンの画面が「タップ」と 「長押し」を区別するのも、同じ仕組みです。指を離すタイミングだけで、まったく違う動作が 起こります。
この種の入力に共通するのは、「まず状況を把握してから、それに基づいて決める」という素直な 二段階では割り切れない、という性質です。ロボティクスの分野では、知覚・計画・行動という 決まった順序でパイプラインを組む設計に対し、Rodney Brooksが提唱したSubsumption Architectureが、その順序そのものへ異議を唱えたことで知られています。NICOLA方式が 「タイミングが意味そのものを担っている場合、判定を知覚と決定にきれいに層分離できない」と 教えてくれるのは、この一般論を、親指シフトという具体的な入力方式でなぞり直した結果に すぎません。
設計原則
原則: 一つの観測だけでは判定が際どくなる場面には、独立した第二の手がかりを用意しておきます。
適用条件: 観測同士の差が十分に大きい場合は、単一の観測だけで判定して構いません。第二の手がかりが必要になるのは、観測が拮抗し、単独では決め切れない場合に限られます。
実装の形: 主たる観測(このawaseの例ではタイミング差)による判定を基本とし、差が閾値を下回るときにだけ、統計的な文脈や事前知識といった別種の手がかりを参照します。
限界: 第二の手がかり自体も、確率的な傾向にすぎません。まれな連鎖や、統計に現れない新しい文脈に対しては、判定を誤る余地が残ります。