第13章:もう要らないのでは、と誰が言うのか
ここまでの章は、開/閉ループ(柱A)と共有/重複(柱B)という、二つの技術的な発見を追ってきました。ここから第VII部では、同じ工夫を開発そのものに向けます。本章が扱うのは、どちらの発見とも独立した第三の軸——技術的に「何を直したか」ではなく、その直し方の発想がどこから来たのかという、開発プロセスそのものの観察です。
同じ時期のrust-nicolaには、方向の異なる二つの大きな変更が同時に進んでいました。ひとつは、長らく積み上げてきた予防策を丸ごと削る変更。もうひとつは、長らく共有してきた仕組みをあえて分ける変更です。どちらも「積み上げてきたものの前提」を疑わなければ生まれようがない種類の変更で、この二つを並べると、大局的な飛躍がどこから始まるのかという問いに、ひとつの答えが見えてきます。
偽陽性が消えても、二重の防御は消えなかった
known-bugs.mdには、2026年7月10日付でこう記録されています。
なぜ偽陰性が実害として顕在化していないと考えられるか(2026-07-10、ユーザー仮説): 現状はcold-start予防(warmup)が広く・保守的にかかっているため
needs_literalがほぼ常にtrueになり、LiteralDetect自体がスキップされるケースが実運用でほとんど発生していない可能性が高い。予防のタイミング・適用範囲を絞り込んだ場合に、この偽陰性が顕在化する可能性がある。実機での検証でしか確認できない。
偽陰性とは、実際には変換前のローマ字が残ったままなのに、システムがそれを見逃してしまう状態のことです。予防が広くかかっているせいで、見逃しを検知するLiteralDetect自体が起動する機会をほとんど失っている、というのがこの仮説の核心でした。この記録が問うているのは、新しいバグへの対処ではなく、今動いている予防機構はもう要らないのではないか、という積み上げてきたものを疑う方向の問いでした。
この仮説の背景には、GJI(Google Japanese Input、Google 日本語入力)のcold-start対策として、awaseがある時期持っていた二重の予防的な防御層があります。ひとつは、long_idleと判定されたときの待機時間を細かく調整する待機行列です。ここで使われていたeager_settle_msは、第3章で600ミリ秒から1500へ、そして500へと調整を繰り返した、あの待機定数です。もうひとつは、VK_Aと確定用のバックスペースをあらかじめ送って様子を見る捨て打ち機能です。
この二層は、最初から設計として一度に用意されたものではありません。GJIが起動直後にどこまで応答できるかは事前に確かめようがなく、個別のバグに対処するたびに「念のため待つ」「念のため様子見のキーを送る」という予防策がひとつずつ足されていったものでした。
その後、合成結果を1文字ずつ確認するreactiveな機構(per-VK confirm)が導入され、BUG-24の偽陽性側には実効的な対処が入りました(BUG-24自体は今も「未修正」のまま記録)。予防に頼らず、実際に起きたことをその都度確認する方針への転換であり、理屈のうえでは待機行列・捨て打ち機能の役割の大半と重複します。それでも二層は「二重の保険」として、動いているコードに触れて壊すより残すほうが安全という惰性で残り続けました。偽陽性側が直ったこと自体はめずらしくなく、めずらしかったのは、直ったあとに残った「この二層は、もう要らないのではないか」という問いのほうでした。
三層がどう重なり、削除後にどう変わったかを図にすると次のようになります。
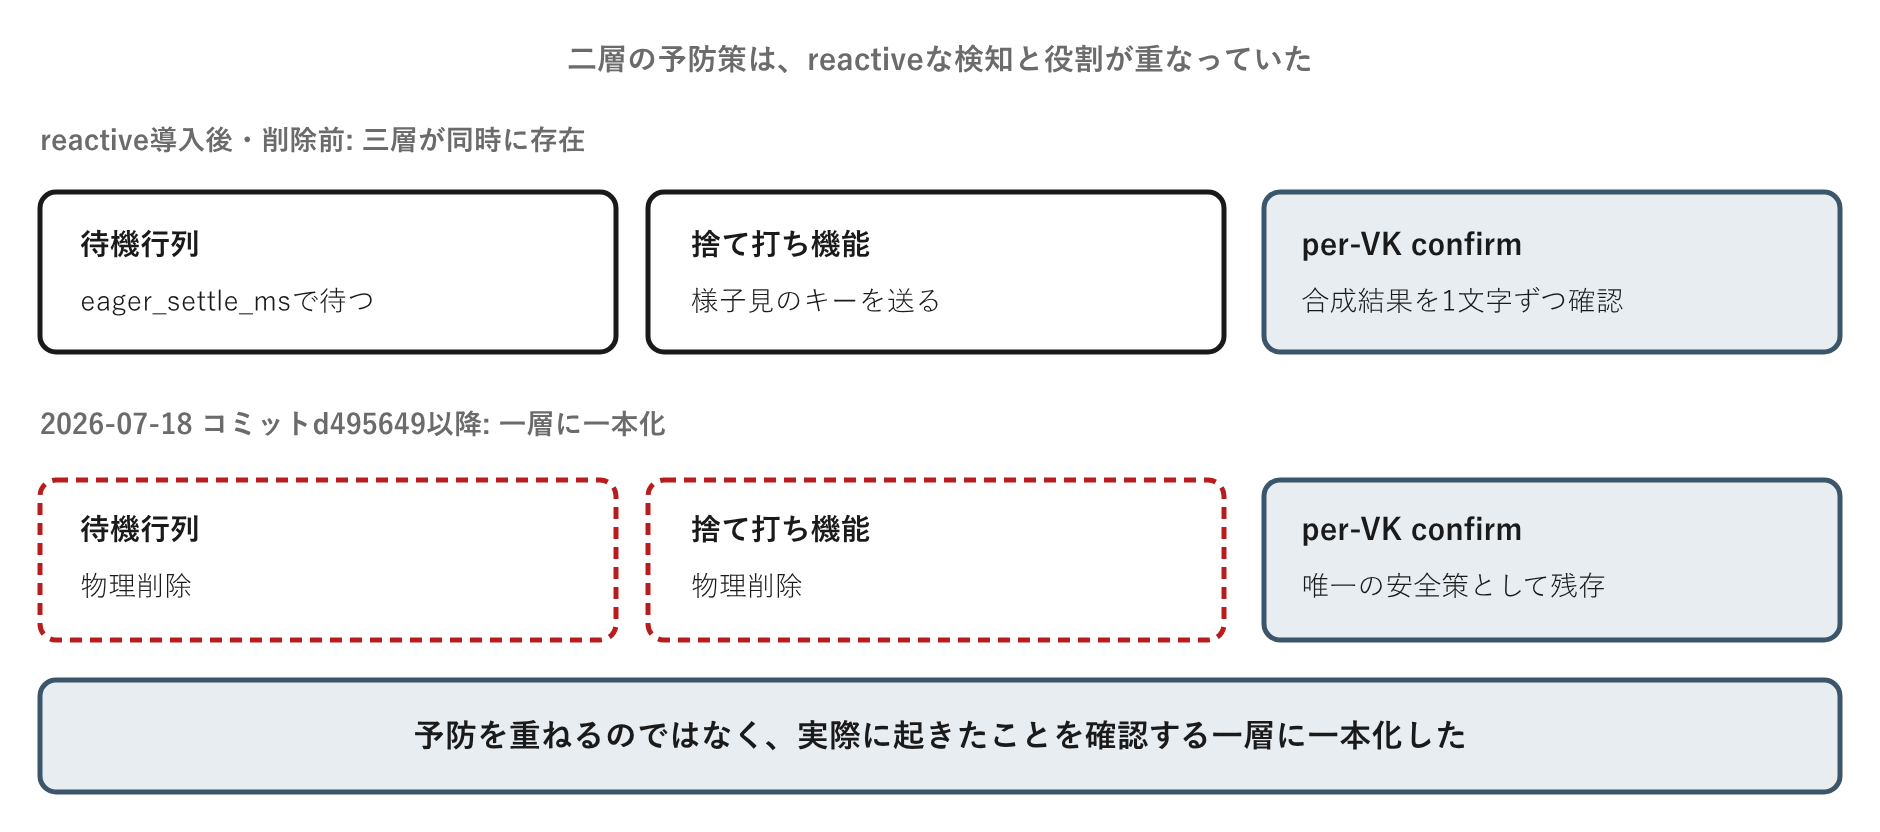
待機行列と捨て打ち機能が担っていた役割の大半は、per-VK confirmという一層に、すでに移っていました。
この仮説を検証するには、通常のバグ修正とは逆方向のリスクを取る決断が必要でした。バグを直す作業はリスクを減らす行為ですが、安全策を外して確かめる作業は一時的にリスクを増やす行為です。何も起きなければ削除の根拠になりますが、外して初めて文字化けが起きれば実際のユーザーが直接被る実害です。検証は、本番の安全策をあえて無効化する診断フラグDIAG_DISABLE_PROACTIVE_TSF_WARMUPを有効にすることで進められました。
外して、確かめた
2026年7月11日、DIAG_DISABLE_PROACTIVE_TSF_WARMUPによって、Windows Terminal・TSF側の3つの防御層——Phase 2のSendFreshF2(様子見のキー送信)、Phase 5aのStartSacrificialWarmup(捨て打ち機能本体)、effective_prepend_f2によるバッチ同梱(送信直前に念のためキーを差し込む処理)——が同時に無効化され、実機のWindows Terminalに実際に日本語を入力して挙動が観測されました。
結果は次の通りでした。エンジン再有効化直後を示すreason=SetOpenTrue系(cold=1,10,11,12,14)では、予防がゼロでもreactiveな検知だけで実害を防げたことが実機で確認できました。既存の"kお"バグのパターンでis_partial_literal()が正しく破損を検知し、ESCキーによる回収が機能したのです。nc_fired=true系(reason=ReinjectConfirmKey/CtrlKeyBypass、cold=5,6,9,13)でも、偽陰性の証拠は見つかりませんでした。
ただしここには留保がついていました。1セッション・限られた条件下での確認にすぎず、idle時間や他アプリ、複数セッションへ条件を広げたわけではないと明記されていたのです。
検証はここで終わりませんでした。続くexperiment/skip-cold-probe-waitブランチで数日間の実機ソークが行われ、Windows TerminalとChromeの両方でcold=61から74を超える範囲まで条件を広げても、疑わしいリテラル化が実際に発生した例はゼロ件でした。
ここまでの道筋を振り返ると、ひとつの型が見えてきます。診断フラグでいったん無効化する、実機で日をまたいでソークする、問題が出なければ恒久化する、恒久化したコードを物理削除する、そして削除の過程で見つかった副産物――到達不能になったコードや、逆に生きていた依存――を調査する。この4段階は、この一件だけの手順ではなく、「もう要らないのではないか」という仮説を安全に検証したい場面であれば、どこでも再利用できる型です。
この4段階を図にすると、次のようになります。
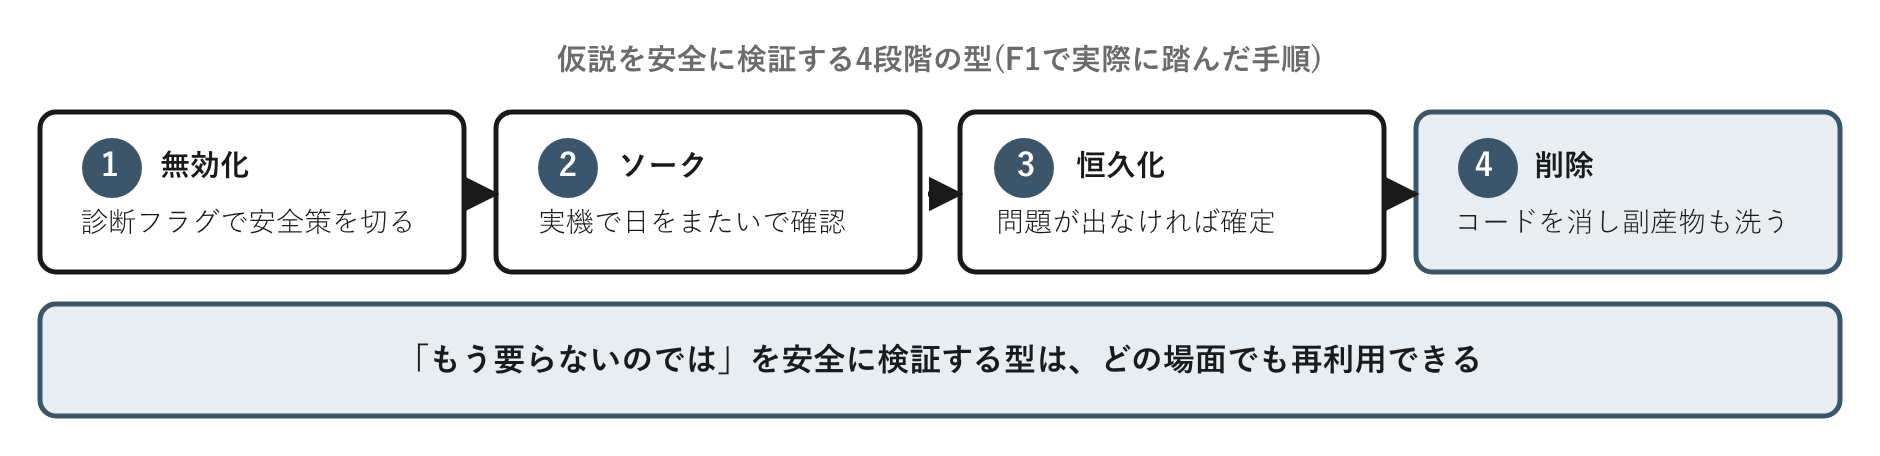
4番目の削除は、恒久化したコードを消すだけでなく、その過程で見つかった副産物まで洗う工程を含みます。
2026年7月18日、コミットd495649が、待機行列と捨て打ち機能の機構一式を物理削除しました。コミットメッセージには、こう記録されています。
捨て駒キー機構一式(StartSacrificialWarmup/SacrificialResend、SacrificialWarmupCoro/ImeOffOnWarmupFsm、is_long_cold重症度分岐)を物理削除。……連鎖的に不要となったdead code……も削除。
削除の範囲は、捨て打ち機能そのものにとどまりませんでした。WarmupKind::FreshF2・ReWarmup・ProbeWithSettle、ColdReason×long_idleのeager_settle_ms・probe_min_ms、Chrome向けのF2事前送信・probe事前待機のコードも消えました。連鎖的に不要となったdead codeも、あわせて削除されました。ConvModeMgr::effective_charset・needs_conv_restore_write・mark_conv_restore_written、ProbeIo::increment_consecutive_count、DispatchResult::SwitchMachine、TsfEnvSnapshot::gji_candidate_visibleです。
この作業は機械的なものではありませんでした。削除しかけてsend_chrome_gji_reinit_and_pollという関数が別経路から直接呼ばれている生きた依存だと気づき、あわてて復元した箇所もあったのです。「もう使われていないはず」という判断は、一件ずつ呼び出し元を追わなければ確定できません。
この一連の削除を可能にした最初の一歩は、AIが修正ループの中で自発的に出した提案ではありませんでした。known-bugs.mdは、次のように明記しています。
ユーザーの判断で
DIAG_DISABLE_PROACTIVE_TSF_WARMUP=trueのまま実運用を継続し、より広い条件下で問題が顕在化するか追加検証中
AI(Claude Sonnet)が担ったのは、この一連の段階を緻密に、手戻り少なく実行する丁寧さでした。それでも、この作業がそもそも始まった理由――「もう疑ってよい」という着想の起点――は、人間側にありました。
同じ着想が、Fableとの壁打ちからも生まれた
F1とは対照的な事例が、同じ時期に並走していました。プロファイル別ドライバへの分離(ADR-081)という、per-appkind設計への転換です。
これは真逆の意味での大局的な提案でした。F1が「積み上げてきたものを削る」飛躍だったのに対し、こちらは「共有してきた仕組みを分ける」飛躍です。IME制御は長らく、共通の汎用ループにプロファイル(awaseが相手にするアプリをIME状態の観測・制御可能性で分類したグループ)ごとの分岐を差し込む設計を採ってきました。共有したほうが保守しやすいという、それ自体は妥当な判断です。Phase 0として、まずは限定的な分離をPR #31で試す(Limited Go)という一歩は、既に踏み出されてもいました。この分離の全体像と、そこから生まれたexperiment-logging.mdという記録規約は、前章で見た通りです。
この着想の核心は、「AppImePolicyは共通ロジックとプロファイル別データという、中途半端な段階で止まっている」というフレーミングでした。この見立ては、Claude Sonnetが通常の修正ループの中で提案したものではなく、Claude Fable 5(以下、Fable)との「壁打ち」――対話相手に前提から疑わせる目的で設ける、意図的な別モードの対話――から生まれたものでした。ADR-081冒頭の「ステータス」節には、こう記録されています。
提案中 → Phase 1計画確定(2026-07-25、Claude Fable 5との壁打ちから起票。……Phase 1計画はOpusによる立案+Fableとの壁打ちで未確定点を解消し確定)。
壁打ちで得られた指摘は、具体的でした。
フレームワークは既にデータの中でフォークしている(プロファイル別定数・アプリ別キー選択)。コードだけ共有してデータが分岐している現状は、統一と分離の悪いとこ取り。
同様の経緯は、ADR-080でも見られました。Sonnet自身は「closed-loop用の機構をopen-loop対象に適用しているミスマッチ」というフレーミングで問題を捉えていましたが、Fableに独立して検討を依頼すると「actuationが終端契約(liveness)を持たない一級市民になっていない」という直交する切り口が返ってきました。通常の修正タスクとして問われるか、前提を疑ってよい対話として問われるかで、返ってくる論点の高さが変わっていたのです。
問いを変えたのは誰か
ここでFableとSonnetを比べ、「賢いモデルに変えたから大きな提案ができた」という物語にまとめてしまいたくなりますが、この結論には飛びつけません。
F2では、モデル(SonnetからFableへ)と問いの立て方(「このバグを直せ」から「この前提を疑ってよい」へ)が、同時に変わっています。したがってF2だけからは、賢いモデルに変えたから飛躍が起きたのか、疑うことをタスクとして渡したから飛躍が起きたのかを、完全には分離できません。これは実験計画でいう交絡変数――ある結果の原因が複数考えられ、互いに区別できない状態――の、典型的な形です。
だからこそ、F1をF2より先に置きました。F1(待機行列・捨て打ち機能の全廃)は、モデルを変えずに、Claude Sonnetのまま、人間が問いを変えただけで飛躍が起きた事例です。F1にはモデル交代という交絡変数が存在しません。この一点で、F1はF2より証拠として強いのです。
F1とF2を並べると、何が同じで何が違うかが一目で分かります。
| 観点 | F1(待機行列・捨て打ち機能の全廃) | F2(per-appkind設計への転換) |
|---|---|---|
| モデル | Claude Sonnet(変更なし) | Claude SonnetからFableへ |
| 問いの立て方 | 「このバグを直せ」から「もう要らないのでは」へ | 最初から「この前提を疑ってよい」 |
| 着想の起点 | ユーザー(人間) | Fableとの壁打ち |
| 交絡変数 | なし | モデルと問いが同時に変化 |
表の「交絡変数」の行が、この2つの事例の違いをそのまま表しています。F1の列には、交絡変数がありません。F2の列と見比べたとき、この違いこそが、F1をF2より先に置く理由です。
モデルを変えずに問いだけを変えても、飛躍は起きました(F1)。だからこそ、モデルと問いが同時に変わったF2についても、少なくとも一部は「問いの立て方」側の効果だと推測する根拠があります。F1という交絡変数のない証拠があるからこそ、F2という交絡した証拠も、ある程度は同じ方向を指していると読めるのです。これは完全な因果証明ではありません。「賢いモデルの効果はゼロだった」とまでは言い切れませんし、言うつもりもありません。あくまで状況証拠の積み上げにすぎない、という留保を、ここに残しておきます。
この2つの事例を並べると、一般化できる形が見えてきます。「次の不具合を直せ」という問いに答え続けるループは、構造的に保守的な提案しか生みません。F1の待機行列・捨て打ち機能の各層は、その都度局所的に正しく、テストも通り、既存の挙動も壊しませんでした。しかし「積み上がった結果、今もこれ全部が必要か」を問う機会は、次のチケットを解決するというタスクの外側にあり、修正ループの中には構造的に存在しません。
大局的な飛躍の起点は、もう要らないのではないかという、リスクを取る仮説を人間が持つことでした。F1の核心は、新しい安全策を追加する判断ではなく、今動いている安全策をあえて外して確かめるという逆方向の決断でした。この技術的な非対称性は、さきほどの認識論的な非対称性とは別の角度からの裏づけです。
AIが本質的に保守的なのではありません。渡された問いの範囲でしか、大局的になれないだけです。実行と着想は別の能力であり、この章で見た4段階の型をAIは高い精度でこなせますが、着想の一歩まで手放してよいわけではありません。大きな変更を提案させたいなら、修正ループの延長として期待するのではなく、疑うこと自体をタスクとして渡す別の対話――壁打ちや独立レビュー、複数モデルへの同一問題の再検討――を意図的に設ける必要があります。人間が担うべきは、何を疑うかという最初の一歩であり、疑ったあとの安全な進め方まで背負う必要はありません。
他分野への転用
「疑ってよい」という役割を、独立させる発想は他の場所にもある
「次の不具合を直せ」という問いと、「この前提を疑ってよい」という問い――この区別は、ソフトウェア開発だけの話ではありません。
医療の現場には、セカンドオピニオンという制度があります。同じ検査データを別の専門家に「この診断で合っていますか」ではなく「前提自体を疑ってよい」というモードで見せると、最初の医師とは異なる結論にたどり着くことがあります。担当医が悪いのではなく、ひとつの治療方針を進める役割の中では、その方針自体を疑う問いが構造的に生まれにくいのです。
組織の意思決定にも、似た仕組みがあります。レッドチーム演習は、通常の業務ループの外側にあえて「これは本当に必要か」を問う役割を切り出します。日々の業務改善は既存の枠組みを前提にした微調整になりがちで、前提を疑う役割を別枠として用意しなければ、その問い自体が生まれません。
これらに共通するのは、疑う役割を日常のループから独立させるという設計です。誰に、どんな問いを、どんなモードで渡すかを設計する発想は、ソフトウェア開発に限らず意思決定の現場全般に転用できます。
本書はここまで、空間をまたぐ同一視(柱B)と時間をまたぐ同一視(柱A)を、コードの中の設計判断として見てきました。本章で見た「疑う役割を独立させる」設計は、同じ問い――何を、いつ、どういうモードで問うか――をコードを書く過程そのものに向けたものです。区別を要する境界は、コードの内側だけにあるとは限りません。
設計原則
原則: 大局的な疑いは、修正ループの外側に、独立したタスクとして切り出さなければ生まれません。
適用条件: 個々の変更がその都度局所的に正しく、テストも通り、既存の挙動も壊していないのに、積み重なった結果全体を疑う機会だけが存在しない場合に働きます。「次の不具合を直す」というタスクの型を繰り返しているだけでは、この機会は生まれません。
実装の形: まず「もう要らないのではないか」という仮説を明示的に立て、安全策を一時的に外すリスクを引き受けます。次に、その仮説を診断フラグとして分離し、実機での長期ソーク・恒久化・物理削除・副産物調査という段階を踏みます。あるいは、通常の修正タスクとは別に、対話相手に前提を疑わせることだけを目的にした対話を、意図的に設けます。
限界: この原則が保証するのは、疑う機会を構造的に用意することだけです。何を疑うべきかという矛先そのものは、原則の外にあります。また、疑うモードを渡す相手が変わったときにどこまで効果が上乗せされるかは、この一件の観察だけでは分離できません。